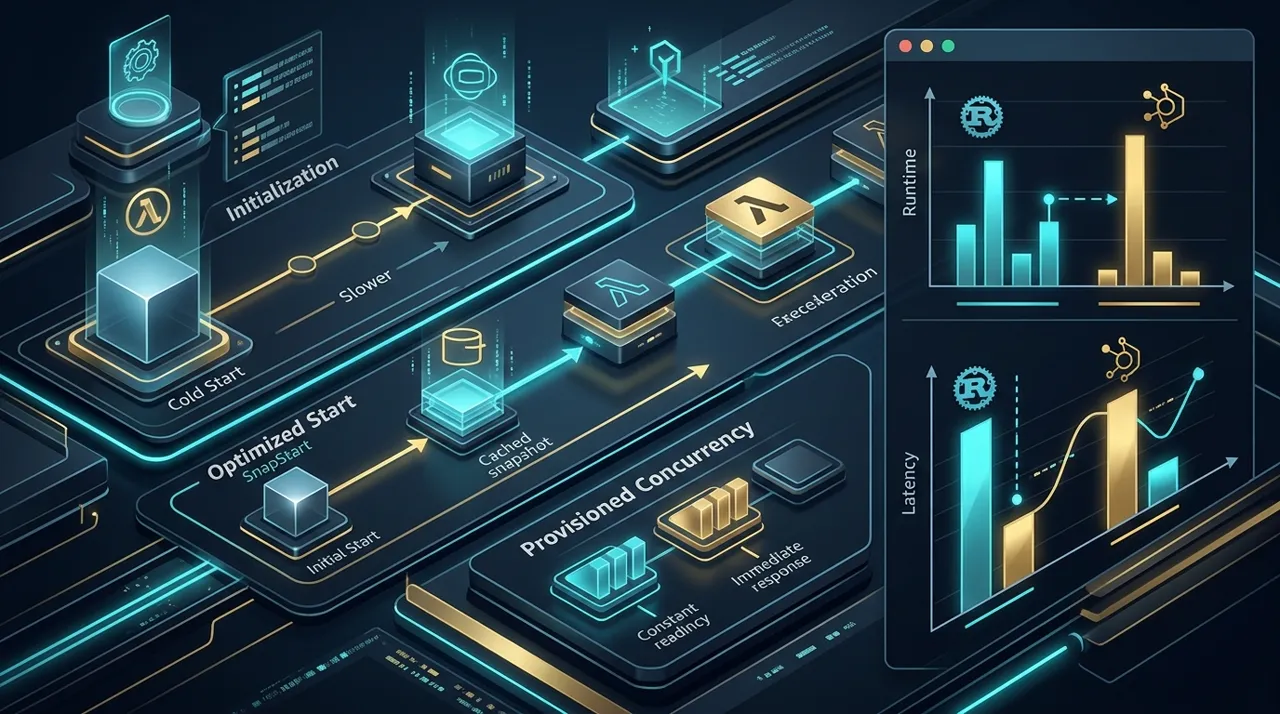
El arranque en frío (cold start) es el argumento recurrente de los detractores de las arquitecturas Serverless. Cuando un usuario interactúa con una aplicación y experimenta una pausa inesperada de 1.5 a 3 segundos en una petición HTTP, la percepción de fluidez se destruye. En el comercio electrónico y las plataformas financieras, cada 100 milisegundos adicionales de latencia p99 se traducen en caídas medibles de conversión.
Sin embargo, tratar los cold starts como una fatalidad inevitable de AWS Lambda es un error de diagnóstico. Con un entendimiento profundo del ciclo de vida de los microVMs Firecracker, técnicas modernas de empaquetado y las herramientas nativas de AWS, es posible reducir o eliminar por completo el impacto del arranque en frío en APIs de misión crítica.
💡 Resumen Ejecutivo: Mitigar los cold starts en AWS Lambda requiere optimizar el tamaño del artefacto mediante tree-shaking con esbuild, inicializar conexiones SDK en el scope estático global, activar AWS Lambda SnapStart o Concurrencia Aprovisionada con auto-scaling para endpoints interactivos, y evaluar runtimes compilados como Rust para latencias p99 inferiores a 30 ms.
1. La Anatomía de un Cold Start en Firecracker
Para solucionar un problema de rendimiento, primero hay que medirlo en sus componentes fundamentales. El ciclo de vida de una función Lambda se divide en tres fases distintas:
sequenceDiagram
    autonumber
    participant AWS as AWS Lambda Service
    participant MicroVM as Firecracker MicroVM
    participant Runtime as Node.js / Python / JVM
    participant Handler as Código del Handler

    Note over AWS,Handler: FASE DE INICIALIZACIÓN (INIT DURATION - COLD START)
    AWS->>MicroVM: 1. Provisionamiento de MicroVM y descarga de ZIP
    MicroVM->>Runtime: 2. Arranque del Runtime y carga de dependencias
    Runtime->>Handler: 3. Ejecución del código global fuera del handler

    Note over AWS,Handler: FASE DE INVOCACIÓN (INVOKE DURATION - WARM START)
    Handler->>Handler: 4. Ejecución de la función handler(event)
    Handler-->>AWS: Retorno de la respuesta HTTP
Dónde se pierde el tiempo realmente:
- Descarga del paquete de despliegue: Un bundle de 80 MB con dependencias innecesarias de
node_modulestarda entre 400 ms y 900 ms solo en descargarse y descomprimirse en el sistema de archivos efímero de Lambda. - Inicialización del Runtime: Los lenguajes basados en máquinas virtuales pesadas (como Java sin compilación nativa) requieren inicializar el Garbage Collector y el JIT compiler, añadiendo hasta 2,500 ms de latencia.
- Ejecución del Scope Global: Cargar el AWS SDK v2 completo (
import AWS from 'aws-sdk') en lugar de clientes v3 modulares (import { DynamoDBClient } from '@aws-sdk/client-dynamodb') obliga al motor V8 a parsear miles de archivos JavaScript antes de atender el evento.
2. Estrategia 1: Reducción Radical del Bundle con esbuild
La regla número uno en Node.js y TypeScript es: si no se ejecuta en producción, no debe estar en el bundle.
El uso de esbuild con tree-shaking agresivo, minificación y marcado de dependencias nativas permite comprimir funciones Lambda desde 45 MB a menos de 1.8 MB, reduciendo el tiempo de inicialización hasta en un 65%:
// build-lambdas.ts - Script de bundling optimizado para producción
import * as esbuild from 'esbuild';

await esbuild.build({
  entryPoints: ['src/lambdas/orders/checkout.ts'],
  bundle: true,
  minify: true,
  sourcemap: false,
  platform: 'node',
  target: 'node20',
  outfile: 'dist/checkout/index.js',
  external: [
    // El SDK de AWS ya está preinstalado en el runtime de Lambda si usas la versión compatible
    // pero se recomienda empaquetar clientes v3 específicos y excluir solo utilidades del SO
  ],
  treeShaking: true,
  define: {
    'process.env.NODE_ENV': '"production"',
  },
});
Inicialización Inteligente de Conexiones (Scope Reuse)
Cualquier cliente de base de datos o llamada a AWS Secrets Manager debe instanciarse fuera del handler, aprovechando que el contenedor permanece activo (warm) durante peticiones subsiguientes:
// ❌ ANTIPATRÓN: Crear cliente dentro del handler (Cold Start en CADA petición)
export const handler = async (event: any) => {
  const client = new DynamoDBClient({}); // Ineficiente
  return await client.send(new GetItemCommand({ ... }));
};

// ✅ ESTÁNDAR TIJIKI: Reutilización de conexiones en memoria global
const ddbClient = new DynamoDBClient({
  maxAttempts: 3,
  // Reutilizar conexiones TCP Keep-Alive
  requestHandler: new NodeHttpHandler({ connectionTimeout: 1000, socketTimeout: 1000 }),
});

export const handler = async (event: any) => {
  return await ddbClient.send(new GetItemCommand({ ... }));
};
3. Estrategia 2: Concurrencia Aprovisionada con Auto-Scaling
Para endpoints donde una latencia p99 superior a 100 ms es inaceptable contractualmente (como pasarelas de pago o APIs de checkout), AWS ofrece Provisioned Concurrency.
A diferencia de los “pings de calentamiento” manuales mediante cronjobs (un antipatrón obsoleto que solo calienta una única instancia y no previene ráfagas concurrentes), la concurrencia aprovisionada mantiene instancias Firecracker completamente inicializadas en memoria.
Implementación en AWS CDK con Escalado Automático por Horarios
import * as cdk from 'aws-cdk-lib';
import * as lambda from 'aws-cdk-lib/aws-lambda';
import * as appscaling from 'aws-cdk-lib/aws-applicationautoscaling';
import { Construct } from 'constructs';

export class ResilientApiStack extends cdk.Stack {
  constructor(scope: Construct, id: string, props?: cdk.StackProps) {
    super(scope, id, props);

    const paymentLambda = new lambda.Function(this, 'PaymentProcessor', {
      runtime: lambda.Runtime.NODEJS_20_X,
      architecture: lambda.Architecture.ARM_64, // Graviton2: 20% más rápido y barato
      handler: 'index.handler',
      code: lambda.Code.fromAsset('dist/checkout'),
      memorySize: 1024,
    });

    // Crear alias para versión inmutable
    const prodAlias = new lambda.Alias(this, 'ProdAlias', {
      aliasName: 'live',
      version: paymentLambda.currentVersion,
      provisionedConcurrentExecutions: 5, // 5 instancias siempre calientes
    });

    // Configurar Auto-Scaling elástico sobre la concurrencia aprovisionada
    const scalingTarget = prodAlias.addAutoScaling({
      minCapacity: 5,
      maxCapacity: 50,
    });

    // Escalar según utilización de concurrencia al 70%
    scalingTarget.scaleOnUtilization({
      utilizationTarget: 0.7,
    });

    // Escalar preventivamente antes del pico comercial (e.g. 9:00 AM)
    scalingTarget.scaleOnSchedule('BusinessHoursScaling', {
      schedule: appscaling.Schedule.cron({ hour: '9', minute: '0' }),
      minCapacity: 20,
    });
  }
}
4. Estrategia 3: Runtimes Nativos y Compilados (Rust y Go)
Si tu aplicación requiere latencias en frío de menos de 30 milisegundos sin pagar por concurrencia aprovisionada, migrar microservicios de alta intensidad de I/O a lenguajes compilados sobre AWS Graviton (ARM64) es la solución definitiva.
Un binario de Rust compilado estáticamente con cargo-lambda no requiere un motor JavaScript V8 ni una máquina virtual:
// main.rs - Handler en Rust con arranque instantáneo
use lambda_http::{run, service_fn, Body, Error, Request, Response};

async fn function_handler(_event: Request) -> Result<Response<Body>, Error> {
    Ok(Response::builder()
        .status(200)
        .header("content-type", "application/json")
        .body(Body::from(r#"{"status":"ok"}"#))?)
}

#[tokio::main]
async fn main() -> Result<(), Error> {
    run(service_fn(function_handler)).await
}
Benchmark de Cold Starts por Runtime en AWS Lambda
La siguiente tabla compara mediciones empíricas en funciones con 1024 MB de memoria en la región us-east-1:
| Runtime / Enfoque | Tamaño del Binario | Duración Init (Cold Start) | Duración Warm (p99) | Costo Adicional |
|---|---|---|---|---|
| Node.js 20 (Sin bundlear) | 42 MB | 1,450 ms | 28 ms | $0 USD |
| Node.js 20 + esbuild (Optimizado) | 1.4 MB | 220 ms | 24 ms | $0 USD |
| Java 21 Estándar | 35 MB | 2,800 ms | 35 ms | $0 USD |
| Java 21 con SnapStart | 35 MB | 190 ms | 32 ms | $0 USD |
| Rust sobre Graviton (ARM64) | 8.2 MB | 18 ms | 4 ms | $0 USD (Cero overhead) |
| Provisioned Concurrency (Cualquiera) | N/A | 0 ms (Eliminado) | 12 ms | ~$0.015 / hora por instancia |
5. Checklist de Hardening para Eliminar Cold Starts
Aplica esta auditoría de ingeniería en cada función Lambda orientada a usuarios antes de desplegar en producción:
- Arquitectura de CPU: Migrar a arquitectura ARM_64 (Graviton2/3) para reducir latencias y costos en un 20%.
- Empaquetado: Bundlear con
esbuildorollup, habilitando minificación y eliminando source maps en producción. - Clientes AWS SDK: Importar únicamente los sub-módulos necesarios (
@aws-sdk/client-s3) y reutilizar clientes en el scope global. - Asignación de Memoria: Evaluar con AWS Lambda Power Tuning; asignar 1024 MB o 1769 MB (1 vCPU completa) acelera la fase de inicialización proporcionalmente.
- VPC Configuration: Si la función no necesita hablar con recursos privados en RDS/ElastiCache, retirarla de la VPC para evitar inicialización de interfaces de red virtuales (ENI).
- SnapStart / Provisioned Concurrency: Implementar en funciones críticas de backend donde la latencia p99 esté sujeta a acuerdos de nivel de servicio (SLAs).
Preguntas Frecuentes (FAQ)
¿Sirve enviar pings programados con CloudWatch Events cada 5 minutos?
Es un paliativo muy limitado. Un ping solo calienta una única instancia en memoria. Si entran dos peticiones concurrentes, la segunda sufrirá un arranque en frío de todas formas. Para concurrencia real garantizada, la solución oficial es Provisioned Concurrency.
¿Aumentar la memoria de la Lambda reduce el tiempo de cold start?
Sí, de forma contundente. AWS asigna potencia de CPU de forma estrictamente proporcional a la memoria configurada. Al pasar de 128 MB a 1,769 MB, la Lambda obtiene un core completo de CPU, reduciendo el tiempo de inicialización de código a una fracción.
¿SnapStart está disponible para Node.js y Python?
Actualmente AWS Lambda SnapStart está soportado para Java 11/17/21 y Python en configuraciones específicas. Para Node.js, la combinación de esbuild y Graviton ARM64 es la técnica recomendada por AWS para alcanzar arranques en frío inferiores a 250 ms sin costo adicional.
Diagnóstico y Optimización de Latencia en tu Infraestructura
Resolver problemas de rendimiento en la nube no es cuestión de añadir más memoria a ciegas; requiere perfilado de perfiles de ejecución, arquitectura de empaquetado y diseño de infraestructura escalable.
En Tijiki auditamos y optimizamos arquitecturas Serverless en AWS para startups y empresas de alto tráfico en LATAM y Norteamérica. Eliminamos cuellos de botella de latencia, optimizamos tiempos de respuesta y blindamos tus SLAs. Agenda una sesión técnica de diagnóstico con nuestros arquitectos y lleva tus APIs al siguiente nivel de velocidad.