Aún persiste en comités de arquitectura el prejuicio de que el modelo Serverless es solo apto para prototipos, cronjobs o aplicaciones internas de baja demanda. La objeción clásica suele ser: “Cuando lleguemos a millones de peticiones, Serverless será demasiado caro y las latencias serán inmanejables; necesitamos un clúster de Kubernetes”.
La evidencia empírica de producción en AWS demuestra exactamente lo contrario. Empresas globales como Coca-Cola, Zalando, Postman y múltiples fintechs procesan miles de millones de eventos diarios sobre arquitecturas puramente Serverless, reduciendo sus costos operativos hasta en un 70% comparado con flotas fijas de contenedores o instancias virtuales.
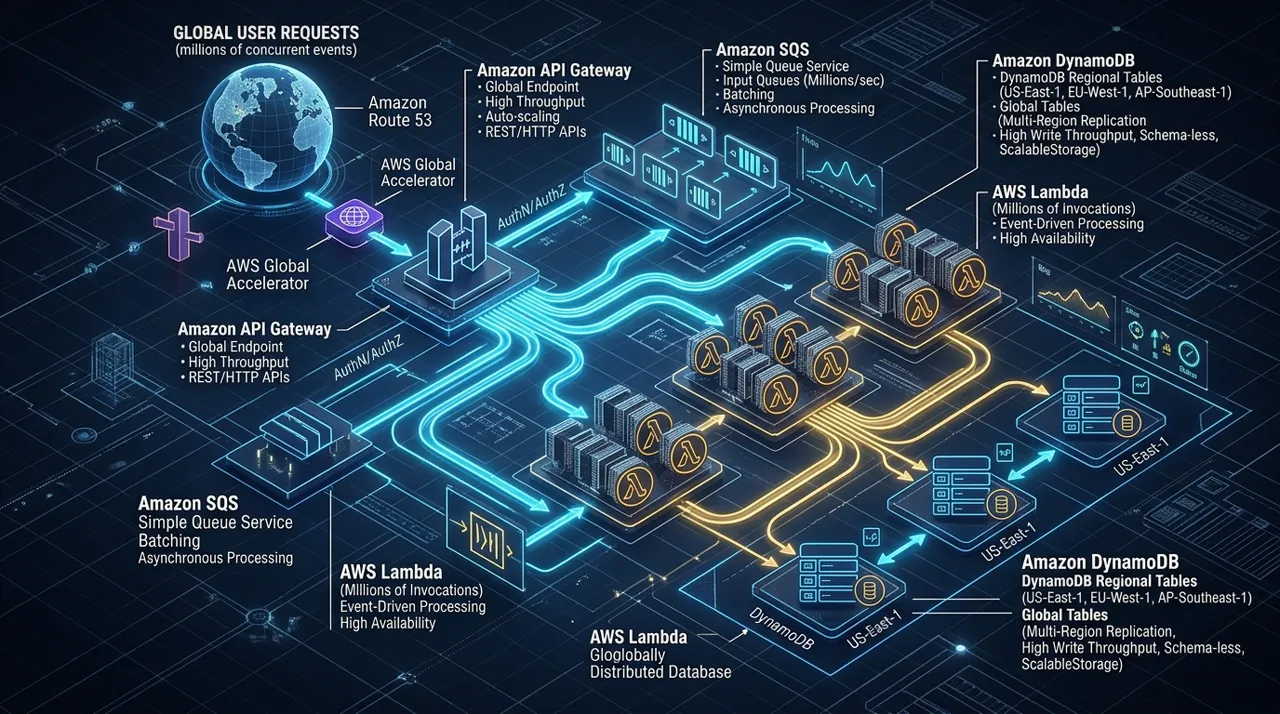
En este artículo analizamos la ingeniería detrás de una arquitectura Serverless en AWS capaz de procesar más de 50 millones de peticiones diarias, los patrones de desacoplamiento asíncrono para proteger el backend y cómo evitar los errores de concurrencia que derriban sistemas a gran escala.
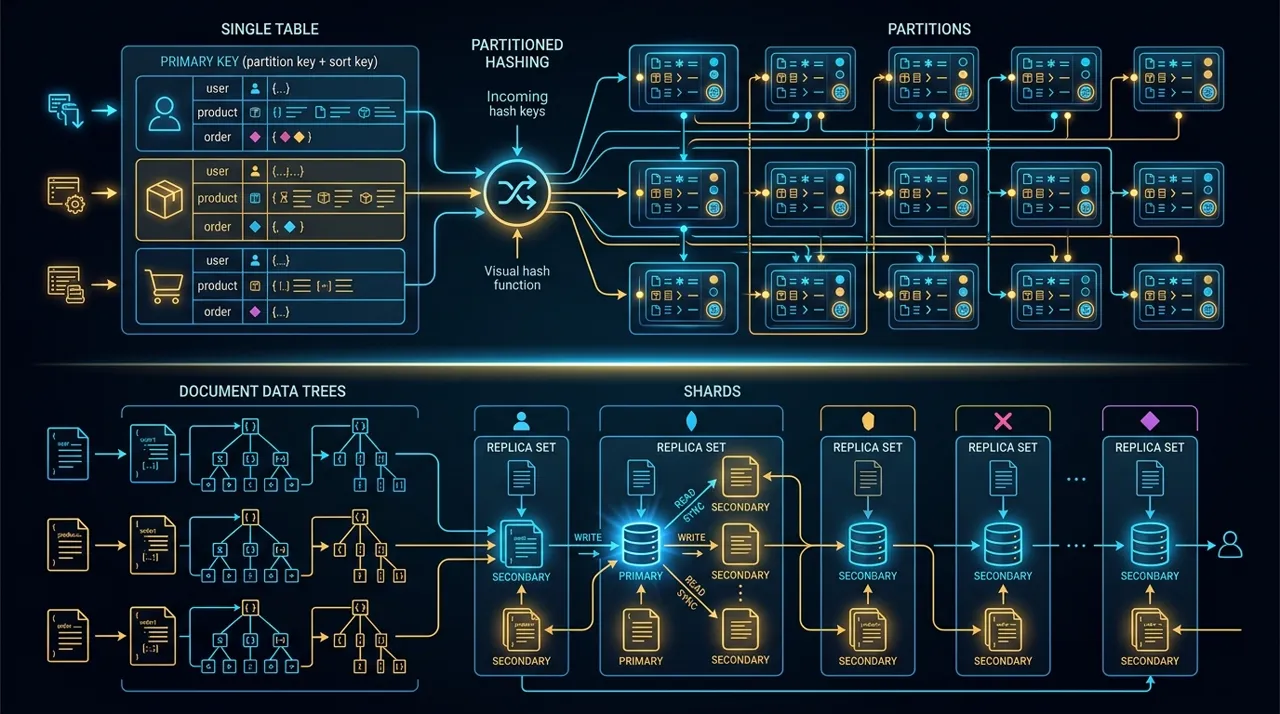
💡 Resumen Ejecutivo: Procesar millones de peticiones en Serverless exige desacoplar la ingesta mediante integración directa entre API Gateway y Amazon SQS (sin ejecutar Lambda en la frontera síncrona), regular la concurrencia reservada para evitar cuellos de botella y modelar DynamoDB en Single-Table Design para absorber ráfagas masivas con latencias sub-10ms.
1. La Trampa de la Arquitectura Síncrona a Gran Escala
Cuando una aplicación atiende 50 peticiones por minuto, encadenar llamadas HTTP síncronas (API Gateway -> Lambda -> RDS PostgreSQL) funciona sin fricción. Pero cuando una campaña de marketing o un evento de alta concurrencia dispara el tráfico a 15,000 peticiones por segundo (RPS), el modelo síncrono colapsa:
graph LR
    subgraph Antipatrón Síncrono (Falla en Ráfaga)
        A1[15,000 RPS] --> B1[API Gateway]
        B1 --> C1[15,000 Lambdas Concurrentes]
        C1 -->|Agotamiento de Pool de Conexiones| D1[Base de Datos Relacional Colapsada]
    end
Por qué falla este enfoque:
- Agotamiento de Conexiones en Base de Datos: PostgreSQL o MySQL soportan típicamente entre 500 y 2,000 conexiones concurrentes. Quince mil ejecuciones de Lambda abriendo conexiones simultáneas saturan el servidor de base de datos en menos de 30 segundos.
- Desperdicio Financiero por Tiempos de Espera: Si la Lambda pasa 800 ms esperando una respuesta externa, AWS te factura por la memoria y el tiempo de CPU durante el cual la función estuvo completamente ociosa esperando I/O.
- Efecto Avalancha (Throttling Cascade): Al alcanzar el límite de concurrencia de la cuenta de AWS (por defecto 1,000 ejecuciones concurrentes en nuevas cuentas), API Gateway comienza a rechazar peticiones con
HTTP 429 Too Many Requests.
2. El Patrón de Ingesta Asíncrona: API Gateway Directo a SQS
La regla de oro de la arquitectura Serverless a gran escala es: nunca proceses de inmediato lo que puedas poner en cola de forma segura.
Para absorber ráfagas masivas sin pagar por cómputo ocioso ni saturar la infraestructura downstream, se utiliza una integración de servicio directa (Service Proxy) entre Amazon API Gateway y Amazon SQS, eliminando por completo a Lambda de la capa de recepción:
sequenceDiagram
    autonumber
    actor Client as Cliente / App Móvil
    participant APIGW as Amazon API Gateway
    participant SQS as Amazon SQS (Buffer de Absorción)
    participant Worker as AWS Lambda (Workers por Lotes)
    participant DDB as Amazon DynamoDB

    Client->>APIGW: POST /v1/events (Payload JSON)
    Note over APIGW,SQS: Integración Nativa Directa (VTL)<br/>Cero cómputo en ejecución
    APIGW->>SQS: SendMessage atómico (Latencia < 15ms)
    APIGW-->>Client: HTTP 202 Accepted (Correlation-ID)

    Note over SQS,Worker: Event Source Mapping con Batching<br/>(10 mensajes por invocación)
    SQS->>Worker: Invocar Lambda con Batch de 10 eventos
    Worker->>DDB: BatchWriteItem persistiendo estado
    Worker-->>SQS: ACK (Elimina mensajes procesados)
Beneficios Arquitectónicos:
- Resiliencia Extrema: SQS puede almacenar miles de millones de mensajes sin degradarse. Si la base de datos se ralentiza, la cola actúa como un amortiguador hidráulico, evitando caídas del sistema.
- Ahorro de Costos Radical: Eliminas el 50% de las invocaciones de Lambda (la función de recepción ya no existe).
- Procesamiento por Lotes (Batching): Una sola ejecución de Lambda procesa 10 o 50 eventos en memoria, reduciendo drásticamente las llamadas a base de datos mediante
BatchWriteItem.
3. Implementación de Producción en AWS CDK (TypeScript)
A continuación, la definición en Infraestructura como Código (IaC) con AWS CDK para desplegar este patrón de ingesta masiva con Dead-Letter Queue (DLQ), escalado elástico y control de concurrencia:
import * as cdk from 'aws-cdk-lib';
import * as apigateway from 'aws-cdk-lib/aws-apigateway';
import * as sqs from 'aws-cdk-lib/aws-sqs';
import * as lambda from 'aws-cdk-lib/aws-lambda';
import * as lambdaEventSources from 'aws-cdk-lib/aws-lambda-event-sources';
import * as iam from 'aws-cdk-lib/aws-iam';
import { Construct } from 'constructs';

export class HighThroughputIngestionStack extends cdk.Stack {
  constructor(scope: Construct, id: string, props?: cdk.StackProps) {
    super(scope, id, props);

    // 1. Dead Letter Queue para mensajes venenosos o fallidos
    const deadLetterQueue = new sqs.Queue(this, 'EventsDLQ', {
      queueName: 'events-ingestion-dlq',
      retentionPeriod: cdk.Duration.days(14),
    });

    // 2. Cola Principal de Ingesta Masiva
    const eventsQueue = new sqs.Queue(this, 'EventsMainQueue', {
      queueName: 'events-ingestion-main',
      visibilityTimeout: cdk.Duration.seconds(30),
      deadLetterQueue: {
        maxReceiveCount: 3,
        queue: deadLetterQueue,
      },
    });

    // 3. Worker Lambda para procesar eventos en lotes
    const workerFunction = new lambda.Function(this, 'EventProcessorWorker', {
      runtime: lambda.Runtime.NODEJS_20_X,
      handler: 'index.handler',
      code: lambda.Code.fromAsset('lambda/worker'),
      timeout: cdk.Duration.seconds(10),
      memorySize: 512,
      reservedConcurrentExecutions: 200, // Protección contra saturación
      environment: {
        NODE_OPTIONS: '--enable-source-maps',
      },
    });

    // Conectar SQS con Lambda con Batching de 10 mensajes y ventana de 2 segundos
    workerFunction.addEventSource(
      new lambdaEventSources.SqsEventSource(eventsQueue, {
        batchSize: 10,
        maxBatchingWindow: cdk.Duration.seconds(2),
        reportBatchItemFailures: true, // Manejo granular de fallos
      })
    );

    // 4. Rol IAM para que API Gateway escriba directo en SQS sin Lambda
    const apigwRole = new iam.Role(this, 'ApiGatewaySqsRole', {
      assumedBy: new iam.ServicePrincipal('apigateway.amazonaws.com'),
    });
    eventsQueue.grantSendMessages(apigwRole);

    // 5. REST API con Integración Directa AWS Service Proxy
    const api = new apigateway.RestApi(this, 'IngestionApi', {
      restApiName: 'high-scale-ingestion-api',
      deployOptions: {
        throttlingRateLimit: 25000,
        throttlingBurstLimit: 50000,
      },
    });

    const sqsIntegration = new apigateway.AwsIntegration({
      service: 'sqs',
      path: `${cdk.Aws.ACCOUNT_ID}/${eventsQueue.queueName}`,
      integrationHttpMethod: 'POST',
      options: {
        credentialsRole: apigwRole,
        requestParameters: {
          'integration.request.header.Content-Type': "'application/x-www-form-urlencoded'",
        },
        requestTemplates: {
          'application/json': 'Action=SendMessage&MessageBody=$util.urlEncode($input.body)',
        },
        integrationResponses: [
          {
            statusCode: '202',
            responseTemplates: {
              'application/json': JSON.stringify({
                status: 'ACCEPTED',
                messageId: "$util.parseJson($input.body)['SendMessageResponse']['SendMessageResult']['MessageId']",
              }),
            },
          },
        ],
      },
    });

    const eventsResource = api.root.addResource('events');
    eventsResource.addMethod('POST', sqsIntegration, {
      methodResponses: [{ statusCode: '202' }],
    });
  }
}
4. Desglose FinOps: Costos Reales a 50 Millones de Peticiones/Mes
Uno de los errores conceptuales más frecuentes es comparar costos asumiendo que los servidores tradicionales operan al 100% de eficiencia las 24 horas del día. En la realidad, para soportar picos impredecibles, una flota de contenedores debe sobreprovisionarse con al menos un 40% de capacidad ociosa.
| Componente | Flota de Contenedores (ECS Fargate + RDS) | Arquitectura Serverless (APIGW + SQS + Lambda + DDB) |
|---|---|---|
| Cómputo Base | 6 instancias Fargate (4 vCPU, 16 GB) 24/7 = $690 USD | Invocaciones por lotes en Lambda (5M ejecuciones) = $22 USD |
| Capa de Ingesta | Balanceador de Carga ALB ($28 base + LCUs) = $115 USD | API Gateway REST (50M requests a $3.50/M) = $175 USD |
| Buffer / Mensajería | Clúster RabbitMQ autogestionado = $180 USD | Amazon SQS (50M peticiones a $0.40/M) = $20 USD |
| Almacenamiento / DB | RDS Multi-AZ db.r6g.xlarge = $540 USD | DynamoDB On-Demand (50M escrituras batch) = $62 USD |
| Mantenimiento Operativo | ~20 horas/mes de DevOps (parches, OS, monitoreo) | Menos de 2 horas/mes (cero parches de infraestructura) |
| Costo Total Estimado | ~$1,525 USD / mes + costo humano | ~$279 USD / mes (Ahorro del 81%) |
5. Antipatrones en Producción a Gran Escala y Cómo Mitigarlos
Al operar a esta escala, los detalles sutiles de configuración marcan la diferencia entre un sistema impecable y una interrupción del servicio:
- Particiones Calientes en DynamoDB (Hot Partitions): Si la clave de partición es una fecha fija (
2026-08-31), todo el tráfico masivo de un día impactará la misma partición física de DynamoDB, saturando el límite de 1,000 WCU por partición. Solución: Añadir un sufijo aleatorio (salt) o utilizar un ID compuesto de alta cardinalidad (tenantId#entityId). - Lambdas en VPC sin necesidad: Conectar Lambdas a subredes privadas de VPC cuando solo consumen servicios nativos de AWS (como SQS y DynamoDB) añade latencia y requiere endpoints de VPC caros. Si tu función no necesita acceder a una base de datos relacional interna en EC2/RDS, ejecútala fuera de la VPC para maximizar rendimiento.
- Falta de
reportBatchItemFailures: Si un lote de 10 mensajes en SQS contiene un mensaje defectuoso y la Lambda arroja un error general, los 10 mensajes regresan a la cola, provocando reintentos innecesarios de los 9 mensajes que sí eran válidos. HabilitarreportBatchItemFailuresen el Event Source Mapping permite confirmar los exitosos y reintentar únicamente el mensaje que falló.
Preguntas Frecuentes (FAQ)
¿Serverless tiene límites duros de concurrencia que impidan escalar a millones de usuarios?
No. El límite inicial de 1,000 ejecuciones concurrentes por región es una cuota suave (soft limit) de seguridad financiera. Mediante una solicitud formal en AWS Service Quotas, este límite se incrementa a decenas de miles de ejecuciones concurrentes sin inconvenientes técnicos.
¿Qué latencia p99 tiene la integración directa de API Gateway a SQS?
Típicamente entre 12 y 25 milisegundos a nivel global. Al no requerir iniciar un entorno de ejecución de código, no existe cold start en la ingesta, lo que garantiza una respuesta casi instantánea para los clientes móviles y web.
¿Cuándo deja de ser rentable Serverless y conviene pasar a contenedores?
Serverless deja de ser óptimo cuando tienes una carga de trabajo homogénea, constante las 24 horas del día (sin valles ni picos) que satura CPUs continuamente (por ejemplo, procesamiento de video en tiempo real o entrenamiento masivo de modelos de ML). Para el 90% de las aplicaciones web, APIs y transacciones de negocio con tráfico fluctuante, Serverless mantiene un ROI y TCO significativamente superior.
Diseña tu Arquitectura para Escalar sin Límites
Construir sistemas en la nube que soporten millones de peticiones diarias sin disparar la factura de AWS requiere experiencia real en patrones asíncronos, diseño de bases de datos distribuidas y optimización milimétrica de recursos.
En Tijiki somos especialistas en diseño de arquitecturas Serverless de alta disponibilidad, reducción de costos cloud mediante FinOps y escalabilidad de APIs corporativas. Si estás preparando tu plataforma para una ronda de inversión, un pico de demanda comercial o buscas modernizar tus sistemas legacy, agenda una sesión de diagnóstico de arquitectura con nuestro equipo de ingenieros senior.