Cuando una aplicación comienza a procesar millones de transacciones mensuales o necesita responder con latencias inferiores a 10 milisegundos para miles de usuarios simultáneos, la base de datos suele convertirse en el primer y más crítico cuello de botella. En el universo NoSQL, la deliberación técnica entre equipos de ingeniería casi siempre enfrenta a dos soluciones líderes: Amazon DynamoDB y MongoDB (principalmente MongoDB Atlas).
Ambos motores abandonaron las restricciones relacionales clásicas (joins costosos y esquemas rígidos), pero representan filosofías de ingeniería profundamente distintas. La elección no es una cuestión de cuál motor es universalmente superior, sino de qué compensación técnica (tradeoff) favorece a tu modelo de negocio: latencia predecible de un solo dígito a cualquier escala con cero mantenimiento de servidores, frente a flexibilidad expresiva de consultas ad-hoc y agregaciones analíticas complejas.
💡 Resumen Ejecutivo: DynamoDB garantiza latencias de 4 a 9 milisegundos en el percentil 99 sin importar el volumen de datos mediante patrones de acceso estrictos por clave. MongoDB ofrece flexibilidad de consultas JSON arbitrarias y agregaciones avanzadas, a cambio de gestionar memoria RAM y tiers de clústeres.
1. Fundamentos Arquitectónicos: Análisis de Tradeoffs
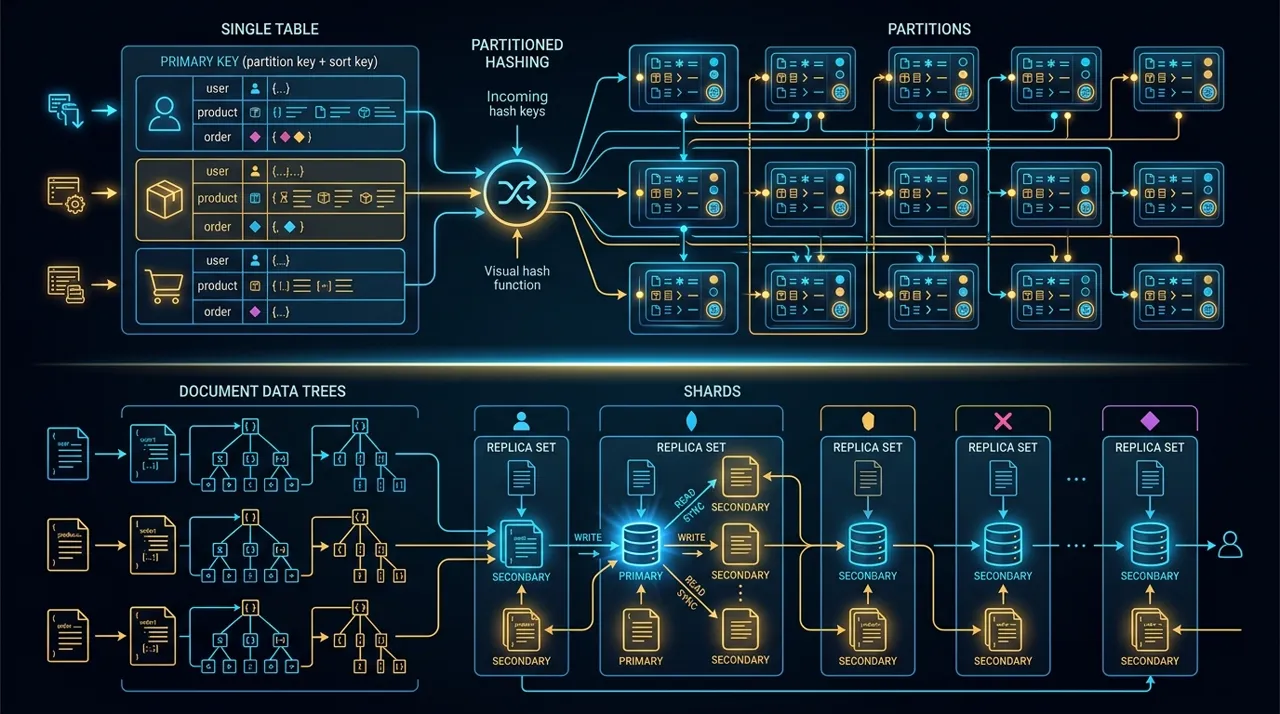
La divergencia técnica fundamental entre ambos motores reside en el motor de almacenamiento interno y el particionado horizontal. DynamoDB es una base de datos distribuida propietaria de AWS, construida sobre almacenamiento SSD de alto rendimiento con consenso Paxos distribuido automáticamente en tres Zonas de Disponibilidad (AZs). DynamoDB intercambia flexibilidad por determinismo absoluto: una consulta por clave primaria tarda exactamente lo mismo si la tabla contiene 100 registros o 500 millones de ítems.
En contraposición, MongoDB funciona sobre el motor WiredTiger, estructurando la información en documentos BSON dentro de colecciones. Utiliza árboles B (B-trees) para índices secundarios y depende críticamente de la memoria RAM (WiredTiger Cache) para mantener calientes los índices y documentos de trabajo. Cuando el conjunto de datos activo supera la memoria RAM aprovisionada, el rendimiento de MongoDB se degrada drásticamente debido a operaciones de paginación en disco.
| Factor de Decisión | Amazon DynamoDB (Serverless Nativo) | MongoDB Atlas (Document Store Distribuido) |
|---|---|---|
| Modelo de Acceso a Datos | Clave-Valor y Consultas por Partición/Ordenación (PK + SK). | Consultas ricas sobre documentos JSON/BSON con operadores anidados. |
| Estrategia de Índices | Índices Secundarios Globales (GSI) y Locales (LSI). Deben planificarse estrictamente. | Índices secundarios arbitrarios, compuestos, geoespaciales y de texto completo. |
| Escalabilidad Horizontal | Particionado automático, elástico y transparente gestionado al 100% por AWS. | Sharding manual o por rangos de fragmentos requiriendo routers mongos y réplicas de configuración. |
| Predecibilidad de Latencia (p99) | Determinista: 4ms a 9ms constantes sin importar el tamaño total de la tabla. | Dependiente de RAM: Sub-milisegundo si está en caché; 50ms–300ms+ durante paginación en disco. |
| Carga Operativa de Mantenimiento | Cero. Sin dimensionamiento de VMs, parches, desfragmentación de índices ni failover manual. | Media a Alta: Monitoreo de memoria, dimensionamiento de instancias (M30/M40) y rebalanceo de chunks. |
| Modelo de Precios | Pago por petición (On-Demand) o Capacidad Aprovisionada (RCU / WCU) + almacenamiento. | Tarifa fija por hora según tier de cómputo y RAM + transferencias de red + IOPS aprovisionados. |
2. Modelado de Datos: Single-Table Design vs. Colecciones BSON
En MongoDB, la intuición de modelado relacional se traslada con facilidad: se definen colecciones separadas (usuarios, pedidos, productos) e incrustan subdocumentos para relaciones de uno a pocos.
En DynamoDB, trasladar un esquema relacional con múltiples tablas individuales destruye la eficiencia de costos y latencia. Para explotar DynamoDB al máximo, los arquitectos emplean Single-Table Design (diseño de tabla única), donde múltiples entidades de negocio conviven en una única tabla física compartiendo nombres genéricos de clave de partición (PK) y clave de ordenación (SK).
flowchart TD
    subgraph DynamoDB Single-Table Design
        A[Tabla Única: TijikiCore] --> B[PK: USER#500 | SK: PROFILE]
        A --> C[PK: USER#500 | SK: ORDER#2026-001]
        A --> D[PK: USER#500 | SK: ORDER#2026-002]
        A --> E[GSI1PK: STATUS#PENDING | GSI1SK: 2026-09-10]
    end

    subgraph MongoDB Modelo Colecciones
        F[Instancia Database] --> G[Colección: Users]
        F --> H[Colección: Orders con items embebidos]
        F --> I[Colección: Products]
        H -. ObjectId Ref .-> G
    end
Cuándo Elegir DynamoDB
- Patrones de Acceso Conocidos y Estables: Autenticación de usuarios, carritos de compra, sesiones, transacciones financieras o registros de auditoría donde las consultas siempre se basan en identificadores concretos o rangos temporales.
- Arquitecturas Serverless en AWS: Funciones Lambda efímeras que escalan violentamente de 0 a 2,000 instancias concurrentes se comunican con DynamoDB mediante peticiones HTTP sin agotar pools de conexiones.
- Sistemas con SLAs Críticos de Latencia: Aplicaciones donde cualquier petición que tarde más de 20 milisegundos impacta negativamente la tasa de conversión o incumple contratos corporativos.
Cuándo Elegir MongoDB Atlas
- Startups en Etapa de Validación con Consultas Cambiantes: Cuando el modelo de negocio evoluciona semana a semana y el equipo de producto requiere filtrar información por campos arbitrarios sin diseñar índices por adelantado.
- Analítica en Tiempo Real y Pipelines de Agregación: Paneles de administración o reportes que exigen operaciones analíticas (
$match,$group,$facet) ejecutadas directamente en el motor de base de datos. - Requerimiento Estricto de Portabilidad Multi-Cloud: Empresas que deben operar indistintamente en Google Cloud, Azure o servidores On-Premise con idéntico motor de base de datos.
3. Implementación de Referencia en Producción: Transacciones Atómicas en DynamoDB
Para utilizar DynamoDB en entornos empresariales de TypeScript, se debe emplear el cliente modular de AWS SDK v3 (@aws-sdk/lib-dynamodb) junto con validación de esquemas Zod y transacciones atómicas para garantizar consistencia sin comprometer el rendimiento:
import { DynamoDBClient } from '@aws-sdk/client-dynamodb';
import {
  DynamoDBDocumentClient,
  TransactWriteCommand,
} from '@aws-sdk/lib-dynamodb';
import { z } from 'zod';

const client = new DynamoDBClient({ region: process.env.AWS_REGION || 'us-east-1' });
export const ddb = DynamoDBDocumentClient.from(client, {
  marshallOptions: { removeUndefinedValues: true },
});

// Validación estricta con Zod del payload de entrada
const CreateOrderSchema = z.object({
  userId: z.string().uuid(),
  orderId: z.string().uuid(),
  totalAmountCents: z.number().int().positive(),
  items: z.array(z.object({
    productId: z.string(),
    quantity: z.number().int().positive(),
  })).min(1),
});

type CreateOrderDTO = z.infer<typeof CreateOrderSchema>;

export async function processOrderTransaction(dto: CreateOrderDTO) {
  const validated = CreateOrderSchema.parse(dto);
  const TableName = process.env.DYNAMODB_TABLE_NAME || 'TijikiCoreData';
  const now = new Date().toISOString();

  // Transacción atómica: persiste la orden e incrementa el contador de usuario
  const command = new TransactWriteCommand({
    TransactItems: [
      {
        Put: {
          TableName,
          Item: {
            PK: `USER#${validated.userId}`,
            SK: `ORDER#${validated.orderId}`,
            Type: 'Order',
            TotalAmountCents: validated.totalAmountCents,
            Items: validated.items,
            CreatedAt: now,
            GSI1PK: 'ORDER#STATUS#PENDING',
            GSI1SK: now,
          },
          // Condición de Idempotencia: evita duplicados si el orderId ya existe
          ConditionExpression: 'attribute_not_exists(PK) AND attribute_not_exists(SK)',
        },
      },
      {
        Update: {
          TableName,
          Key: {
            PK: `USER#${validated.userId}`,
            SK: 'METADATA',
          },
          UpdateExpression: 'ADD TotalOrdersCount :one, TotalSpentCents :val',
          ExpressionAttributeValues: {
            ':one': 1,
            ':val': validated.totalAmountCents,
          },
        },
      },
    ],
  });

  try {
    await ddb.send(command);
    return { success: true, orderId: validated.orderId };
  } catch (error: any) {
    if (error.name === 'TransactionCanceledException') {
      throw new Error('Transacción rechazada: El pedido ya fue procesado o la cuenta no existe.');
    }
    console.error('[CRITICAL_DB_ERROR]', error);
    throw error;
  }
}
4. Análisis FinOps: Comparativa Económica Real a Escala
El modelo económico de ambas opciones es radicalmente dispar: Pago por Capacidad Consumida vs. Alquiler de Máquinas Virtuales.
Escenario de Producción a Escala Media-Alta
Parámetros: 50,000,000 lecturas mensuales + 10,000,000 escrituras mensuales. Tamaño promedio por ítem: 1.5 KB. Volumen de almacenamiento: 300 GB.
1. Costo con Amazon DynamoDB (Modo On-Demand):
- Escrituras: 10M escrituras × 2 WRUs (1.5 KB = 2 bloques de 1 KB) = 20M WRUs
  Costo: 20M × $1.25 / 1M = $25.00 USD
- Lecturas (Consistencia Eventual): 50M lecturas × 0.5 RRUs = 25M RRUs
  Costo: 25M × $0.25 / 1M = $6.25 USD
- Almacenamiento (300 GB - 25 GB gratuitos de nivel siempre gratis):
  275 GB × $0.25 / GB = $68.75 USD
- Total Mensual DynamoDB: ~$100.00 USD / mes

2. Costo con MongoDB Atlas (Clúster Dedicado de Alta Disponibilidad):
- Clúster M40 (4 vCPUs, 16 GB RAM) necesario para mantener los 300 GB en memoria:
  $0.54 / hora × 730 horas = ~$394.20 USD
- Almacenamiento NVMe aprovisionado (300 GB + margen de seguridad): ~$60.00 USD
- Copias de seguridad continuas y transferencia de datos entre AZs: ~$45.00 USD
- Total Mensual MongoDB Atlas: ~$499.20 USD / mes
Conclusión FinOps: Para patrones de acceso clave-valor y cargas variables, DynamoDB es aproximadamente un 80% más económico ($100 vs $499 USD) porque no pagas por gigabytes de memoria RAM ociosa durante las horas de baja demanda.
5. Antipatrones Críticos y Errores en Producción
1. El Peligroso Uso de Scan en DynamoDB
Ejecutar operaciones de escaneo (ScanCommand) en rutas de peticiones web para buscar registros por atributos no indexados.
- El Impacto: DynamoDB lee la tabla entera, devorando unidades de lectura y disparando los tiempos de respuesta de 5ms a más de 10,000ms.
- La Solución: Todo requerimiento de búsqueda en DynamoDB debe mapearse a una operación
Queryutilizando índices secundarios globales (GSI).
2. Consultas Desindexadas y “Paging Storms” en MongoDB
Filtrar colecciones de millones de documentos sin un índice compuesto que soporte la consulta.
- El Impacto: El motor WiredTiger desaloja páginas calientes de la memoria RAM para escanear el disco, generando saturación de CPU y bloqueos en cascada en todo el clúster.
- La Solución: Auditar regularmente el Performance Advisor en MongoDB Atlas y asegurar que el ratio de documentos examinados frente a documentos devueltos sea cercano a 1:1.
Preguntas Frecuentes (FAQ)
¿Cómo maneja DynamoDB el soporte de transacciones ACID?
DynamoDB cuenta con transacciones ACID completas mediante las operaciones TransactWriteItems y TransactGetItems, permitiendo mutar de forma coordinada hasta 100 ítems o 4 MB de datos con aislamiento serializable.
¿Se pueden ejecutar agregaciones analíticas complejas en DynamoDB?
No directamente. DynamoDB no posee un motor de agregación como el $group de MongoDB. Para analítica avanzada sobre DynamoDB, se activan DynamoDB Streams para replicar eventos en tiempo real hacia servicios analíticos como Amazon OpenSearch o AWS Athena.
¿Cuál es la principal ventaja de MongoDB sobre DynamoDB?
La velocidad de iteración y la expresividad del lenguaje de consultas. Si no conoces con precisión cómo se consultarán los datos en el futuro, MongoDB permite agregar filtros y construir agregaciones sin tener que rediseñar la estructura de particiones.
Conclusión y Diagnóstico de Arquitectura
Elegir entre DynamoDB y MongoDB no debe responder a preferencias de desarrollo, sino a la naturaleza de tus datos y requerimientos de escala. Si buscas mínimo costo operativo, escalabilidad serverless y latencias predecibles en AWS, DynamoDB es la mejor alternativa. Si tu producto exige consultas analíticas ad-hoc, esquemas profundamente anidados y portabilidad multi-cloud, MongoDB Atlas ofrece la mayor flexibilidad.
🛠️ ¿Dudas sobre cómo modelar tus datos en NoSQL o tu base de datos cloud no escala?
En Tijiki auditamos arquitecturas de datos, optimizamos diseños en DynamoDB y MongoDB Atlas, y eliminamos cuellos de botella de rendimiento y costos.
👉 Agendar Sesión de Diagnóstico de Arquitectura (30 min con un Arquitecto Senior)